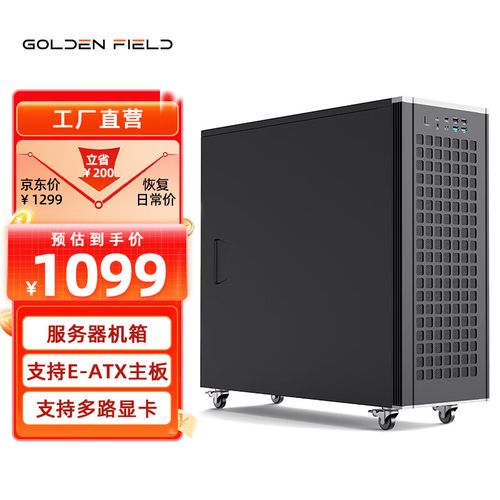
渦輪公版4/8卡RTX 5090/4090服務器工作站 AI推理與訓練的終極解決方案
前言
在當今人工智能技術飛速發展的時代,對大算力的需求與日俱增。無論是深度學習的模型訓練,還是大規模推理部署,傳統的消費級單卡甚至雙卡配置已經難以滿足日益復雜的AI工作負載。為此,搭載RTX 5090或RTX 4090渦輪公版的多卡服務器和工作站應運而生,成為科研機構、AI初創公司和大型企業部署AI基礎設施的熱門選擇。
為什么選擇渦輪公版?
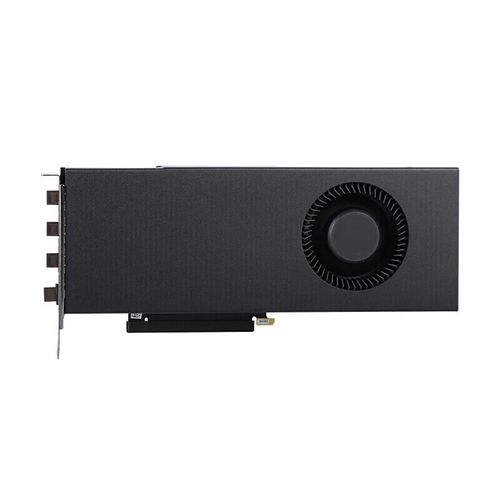
與常見的開放式散熱風扇顯卡不同,渦輪公版顯卡采用封閉式渦輪散熱設計,熱量從顯卡尾部的散熱口集中排出。這種設計在多卡并排部署時具有天然優勢:它能有效避免熱空氣在機箱內部循環堆積,讓每張顯卡都能獲得穩定的冷空氣,從而維持長時間高負載運行下的性能穩定。對于需要4卡或8卡密集部署的工作站而言,渦輪公版幾乎是必然選擇。渦輪公版通常符合更嚴格的工業標準和尺寸規范,便于在機架式服務器中密集安裝。
RTX 4090:成熟可靠的現役旗艦
RTX 4090基于Ada Lovelace架構,擁有16384個CUDA核心,配備24GB GDDR6X顯存,顯存位寬384-bit,帶寬高達約1TB/s。憑借其強大的FP16和FP8張量核心性能,單卡即可提供出色的AI訓練和周模型推理能力。在多卡互聯方面,4090支持PCIe 4.0/5.0總線,在服務器主板上可實現大帶寬互聯,配合定制的多卡拓撲驅動方案,多卡并行效率可顯著提升。通過NVLink?實際消費級40系并不支持NVLink,3000系才支持橋接互聯,多卡通信主要依賴PCIe對于大模型訓練中的梯度同步可以接受這在多卡8卡集群中,張量并行和流水線分布式訓練仍然可以高效運作,同時存儲從PCIe結構還可以靈活搭配高帶寬CSD例如使用PCIe條多個高ExpressNV模型Storage固態模型輕松達到RAID配置避免Read-load i
模型效率。。本地推理可以使用GPT模型的流水線--效率可以達到理想
……
如若轉載,請注明出處:http://m.zmag.com.cn/product/48.html
更新時間:2026-10-18 20:14:10